

服務架構圖:呼叫端往下經過 middleware,分成 POST /ask 與 POST /documents 兩條路,兩條都從同一個 Retriever 介面出去;一條橘色虛線以下是被這支服務包起來的 RAG 核心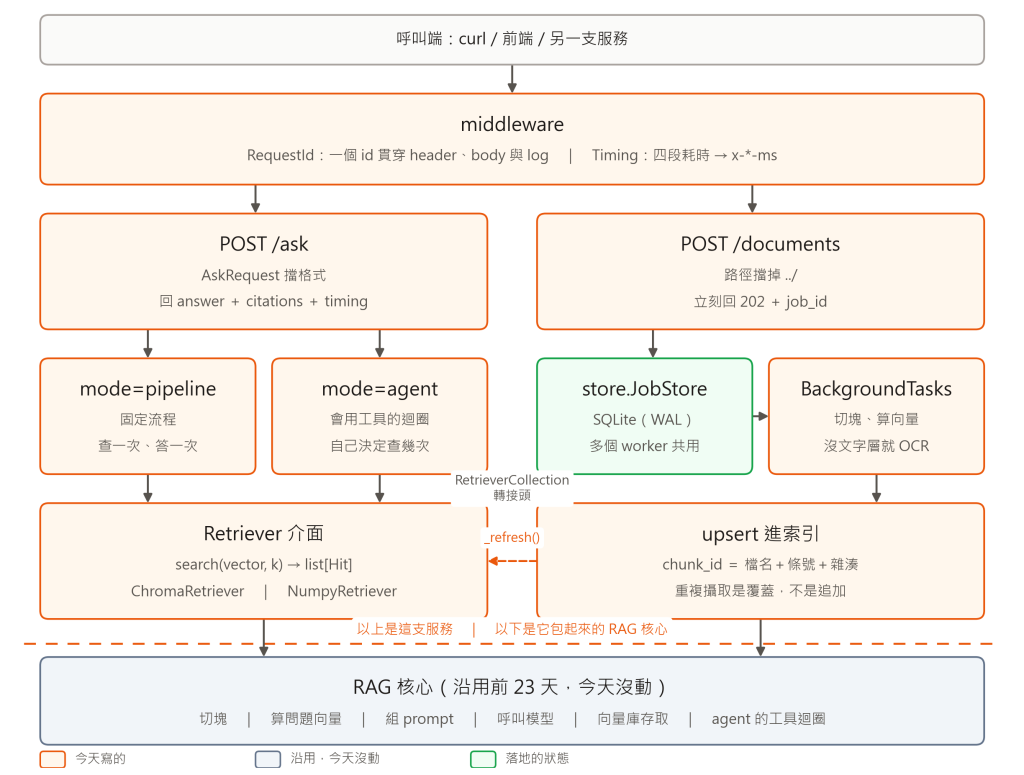
上篇走圖的左半邊,這篇走右半邊,外加底下那條共用的快取,概念圖如下。這是本系列第 25 篇。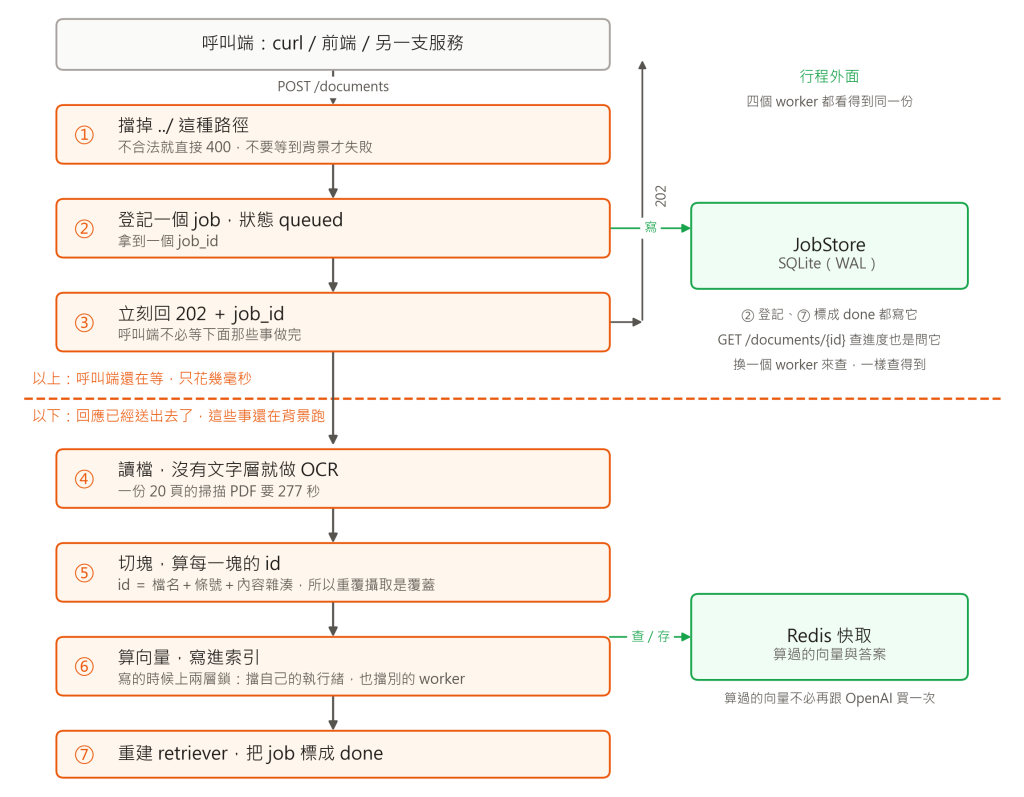
ingest.py:把一份文件變成索引裡的塊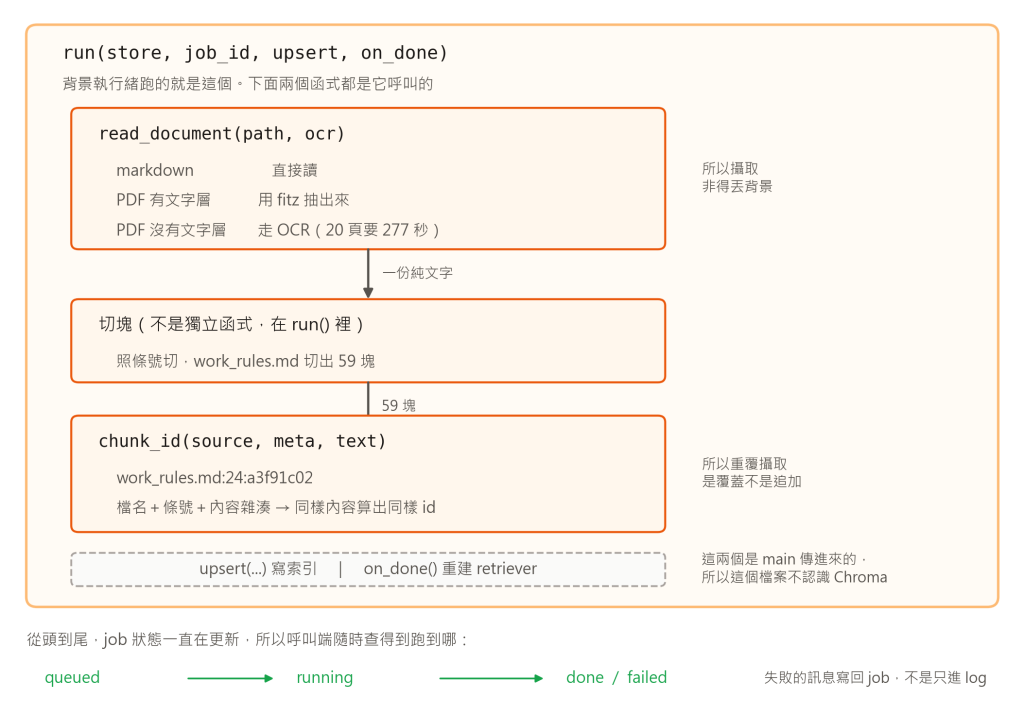
OCR 很慢,一份 20 頁的掃描 PDF 要 277 秒,所以 POST /documents 只登記 job 就回 202。
def chunk_id(source: str, meta: dict, text: str) -> str:
    digest = hashlib.sha256(text.encode("utf-8")).hexdigest()[:8]
    return f"{Path(source).name}:{meta.get('article_no', 0)}:{digest}"
run() 的狀態是 queued → running → done/failed。檔案不存在算 job 失敗、不算 POST 失敗,因為呼叫端要先拿到 job_id 才查得到原因。
store.py:job 狀態存哪裡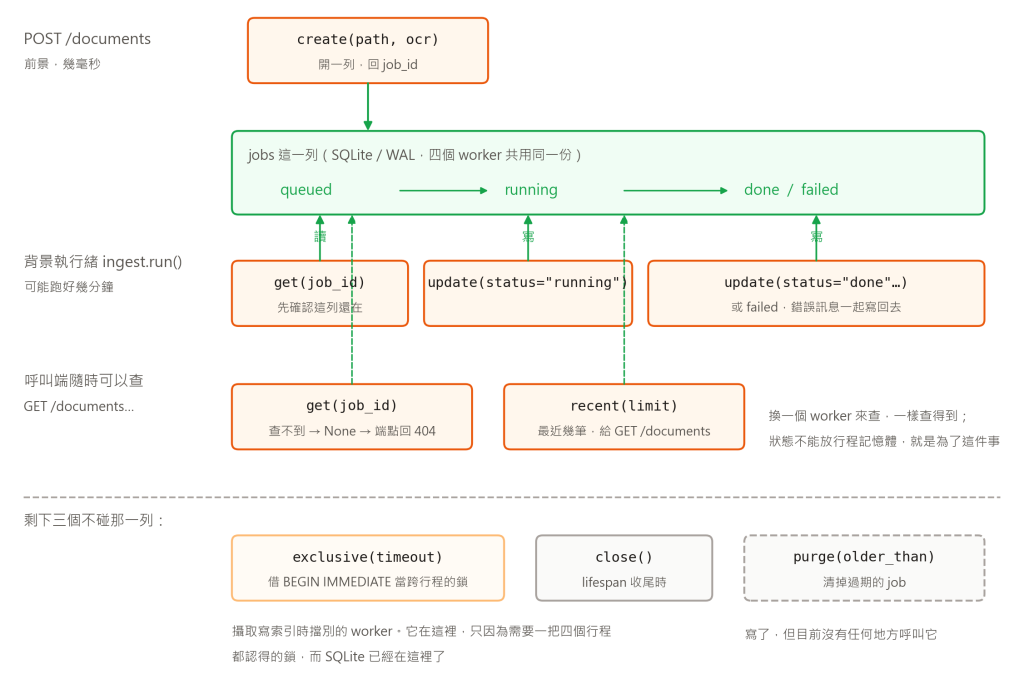
資料庫一樣用 SQLite,WAL 模式,多個行程可以同時讀,而寫很少,一個 job 只寫三次。exclusive() 借 BEGIN IMMEDIATE 當鎖用:Chroma 內嵌模式不是設計給兩個行程同時寫的。連線是 thread-local 的,sqlite3 的連線不能跨執行緒。
cache.py:換掉那個會壞的存檔兩個快取檔,存算過的問題向量與問過的答案。存法是整包讀進來、改一個 key、整包寫回去:
def _save_json(path: Path, data: dict) -> None:
    path.write_text(json.dumps(data, ensure_ascii=False), encoding="utf-8")
這一行整個系列都在用,一次都沒錯過。服務有兩條執行緒同時走到它,一條讀到寫到一半的檔案:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x90 in position 393
rag_core.py 是前 23 天的證據不能改,所以在啟動時換掉那兩個函式。
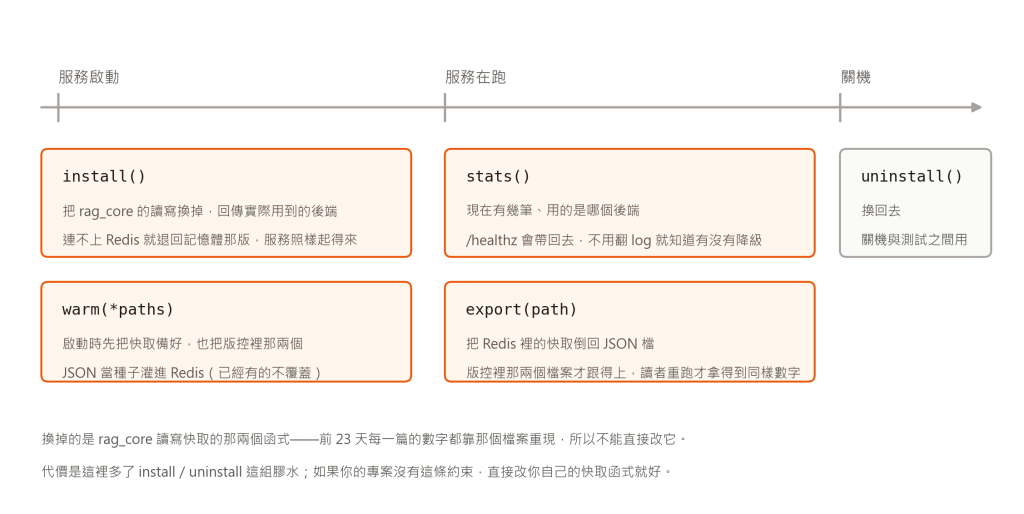
換成什麼?放回檔案只會再壞一次,放進 process 記憶體則是開第二個 worker 就各存各的。
要兩個都避開,快取得搬出這支程式。
Redis 是一個獨立跑的資料庫,資料放記憶體裡所以快,只做一件事:給它 key,還你 value。
它是另一支程式,不在你的 process 裡 —— 服務透過網路去問它,所以幾個 worker、幾台機器問,拿到的都是同一份。在這裡它就存那兩個快取,那是花錢跟 OpenAI 換來的東西。
| 放哪 | 誰看得到 | 服務重啟 |
|---|---|---|
| 檔案 | 都看得到,但會互相寫壞 | 還在 |
| process 記憶體 | 只有自己那個 worker | 沒了 |
| Redis | 所有 worker、所有容器 | 還在 |
rag_core.py 一個字都沒改:它對快取只做查 key、拿值、設值、存檔四件事,塞一個行為像 dict、實際上在跟 Redis 講話的東西進去就行。
兩個決定:Redis 掛了要變慢變貴、不是變 500,讀寫失敗一律當沒命中;版控裡那兩個 JSON 還是要有用,啟動時拿它當種子灌進去,已經有的不覆蓋。
Docker Desktop 的容器列表,files 這個 compose 專案就是這支服務,底下是 api 與 redis 兩個容器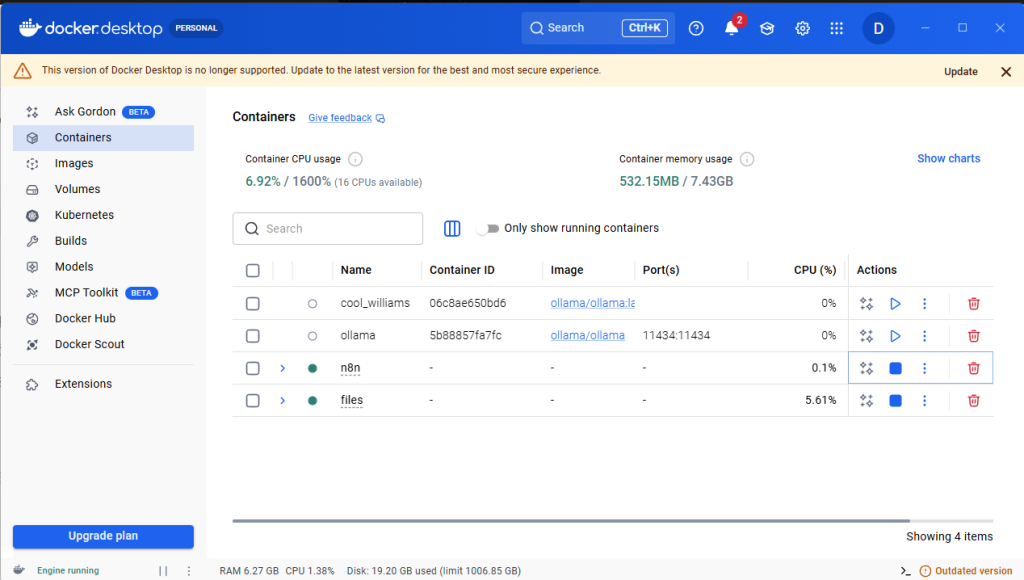
/healthz 會把用的是哪個後端回報出來("cache": {"backend": "redis", "keys": 1644}),這樣不用翻 log 就知道有沒有默默降級成記憶體那版。
下面是同一題問四次的結果,其中第四次是把服務容器整個砍掉重建之後再問的:
| 第幾次 | embed | llm | total | 命中 |
|---|---|---|---|---|
| 1(冷) | 3820.2 ms | 2213.4 ms | 6082.0 ms | 否 |
| 2 | 1.5 ms | 0.8 ms | 11.5 ms | 是 |
| 3 | 0.8 ms | 0.6 ms | 11.2 ms | 是 |
| 4(新容器) | 0.9 ms | 1.1 ms | 15.4 ms | 是 |
四次的答案一字不差。第四次才是真正要證的那件事:容器換掉了,快取還在,
因為它已經不住在容器裡面了。
timing.py:把一次請求拆成四段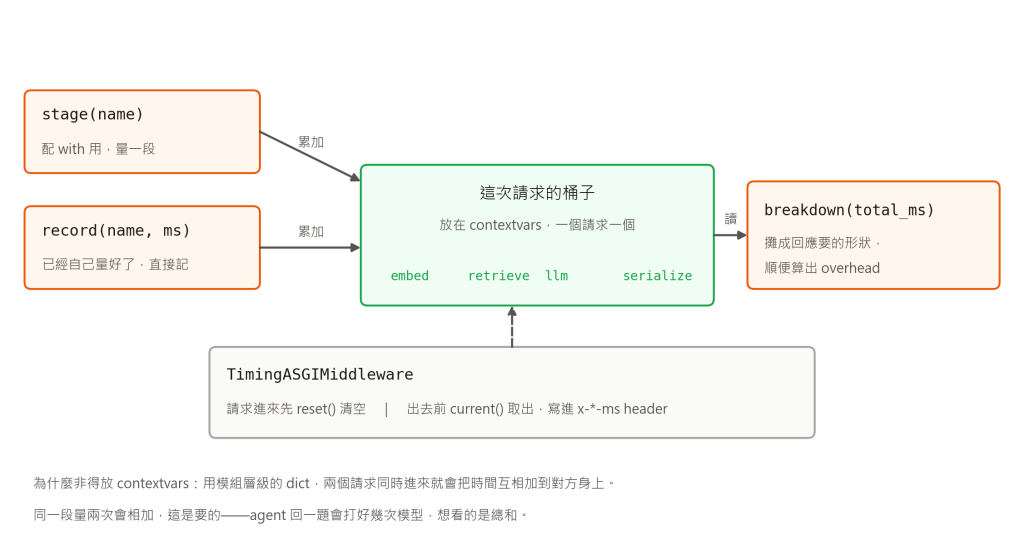
那個「桶子」放在 contextvars 裡,一個請求一個。如果用模組層級的 dict,兩個請求同時進來就會把時間互相加到對方身上。
量一段的寫法是 with stage("llm"):,包住哪幾行就量哪幾行,離開那個區塊時間自動記進桶子。
這裡有三個細節。計時寫在 finally 裡,所以那幾行中途丟例外也照樣記得到—— 出錯的那些請求,往往正是你最想知道它慢在哪的。同一段量兩次會相加,這是要的行為,因為 agent 回答一題會打好幾次模型,我們想看的是總和。最後,計時用 perf_counter() 而不是 time.time(),後者會被系統校時往回調,調到的那一刻會量出負數。
main.py:啟動順序與兩層鎖| 函式 | 做什麼 |
|---|---|
lifespan(app) |
裝常駐快取 → 開 JobStore → 建索引 → 把 ready 設成 True |
_collection() |
每次都跟 client 重拿 collection,不把 handle 抓在手上 |
_refresh() |
重建兩個 retriever 與「條號 → 原文」的對照表 |
_require_ready() |
索引還沒好就丟 503 |
ingest_document() |
擋路徑、登記 job、丟背景、回 202 |
ingest_document() 做四件事,如下圖所示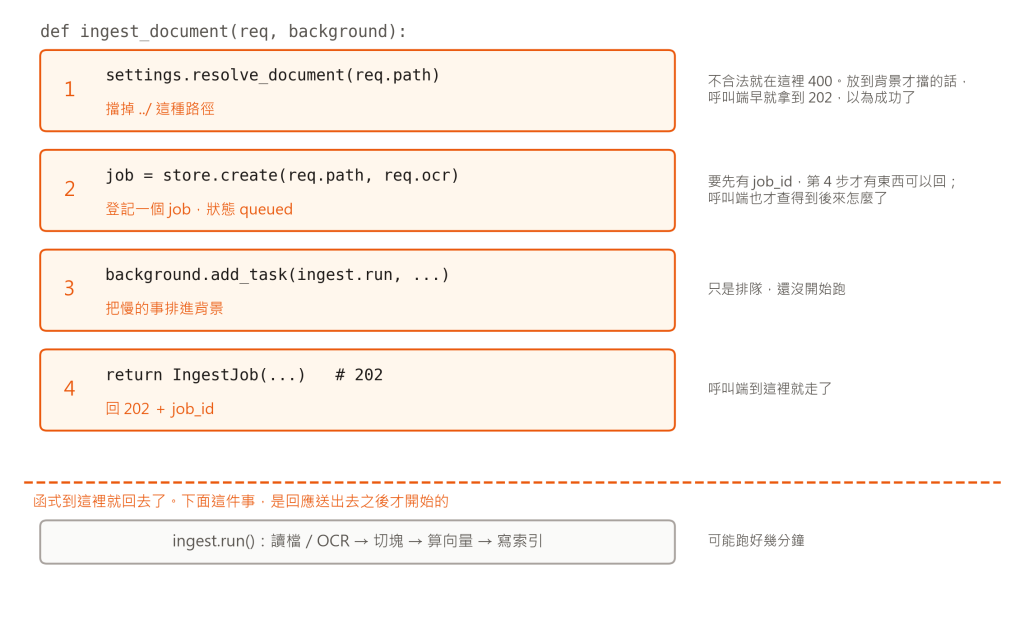
一題要一秒多,其中 78% 在等模型吐完,在那之前使用者看到一片空白。
明天 /ask 多一條 SSE 的路,總時間不會變短,但第一個字出現的時間會。citations 在第一個 token 之前就確定了,可以先送,讓前端先把出處畫出來。


 iThome鐵人賽
 看影片追技術